EmbeddingGemma 2 ищет смысловые совпадения между текстом, кодом, изображениями, видео и аудио. Разбираем устройство компактной модели и цену экономии памяти.
Google выпустила EmbeddingGemma 2 — компактную открытую модель для поиска по нескольким видам данных. Она представлена 6 октября и переводит текст, код, изображения, видео и аудио в общее пространство числовых представлений. Благодаря этому запрос и подходящий материал могут быть записаны в разных форматах.
Идею легко представить на личном архиве. Человек помнит содержание ролика, но не его название; в папке лежат записи с техническими именами файлов. Смысловой поиск позволяет описать нужный эпизод словами и искать близкие фрагменты среди медиа. Название файла перестаёт быть единственным доступным ориентиром.
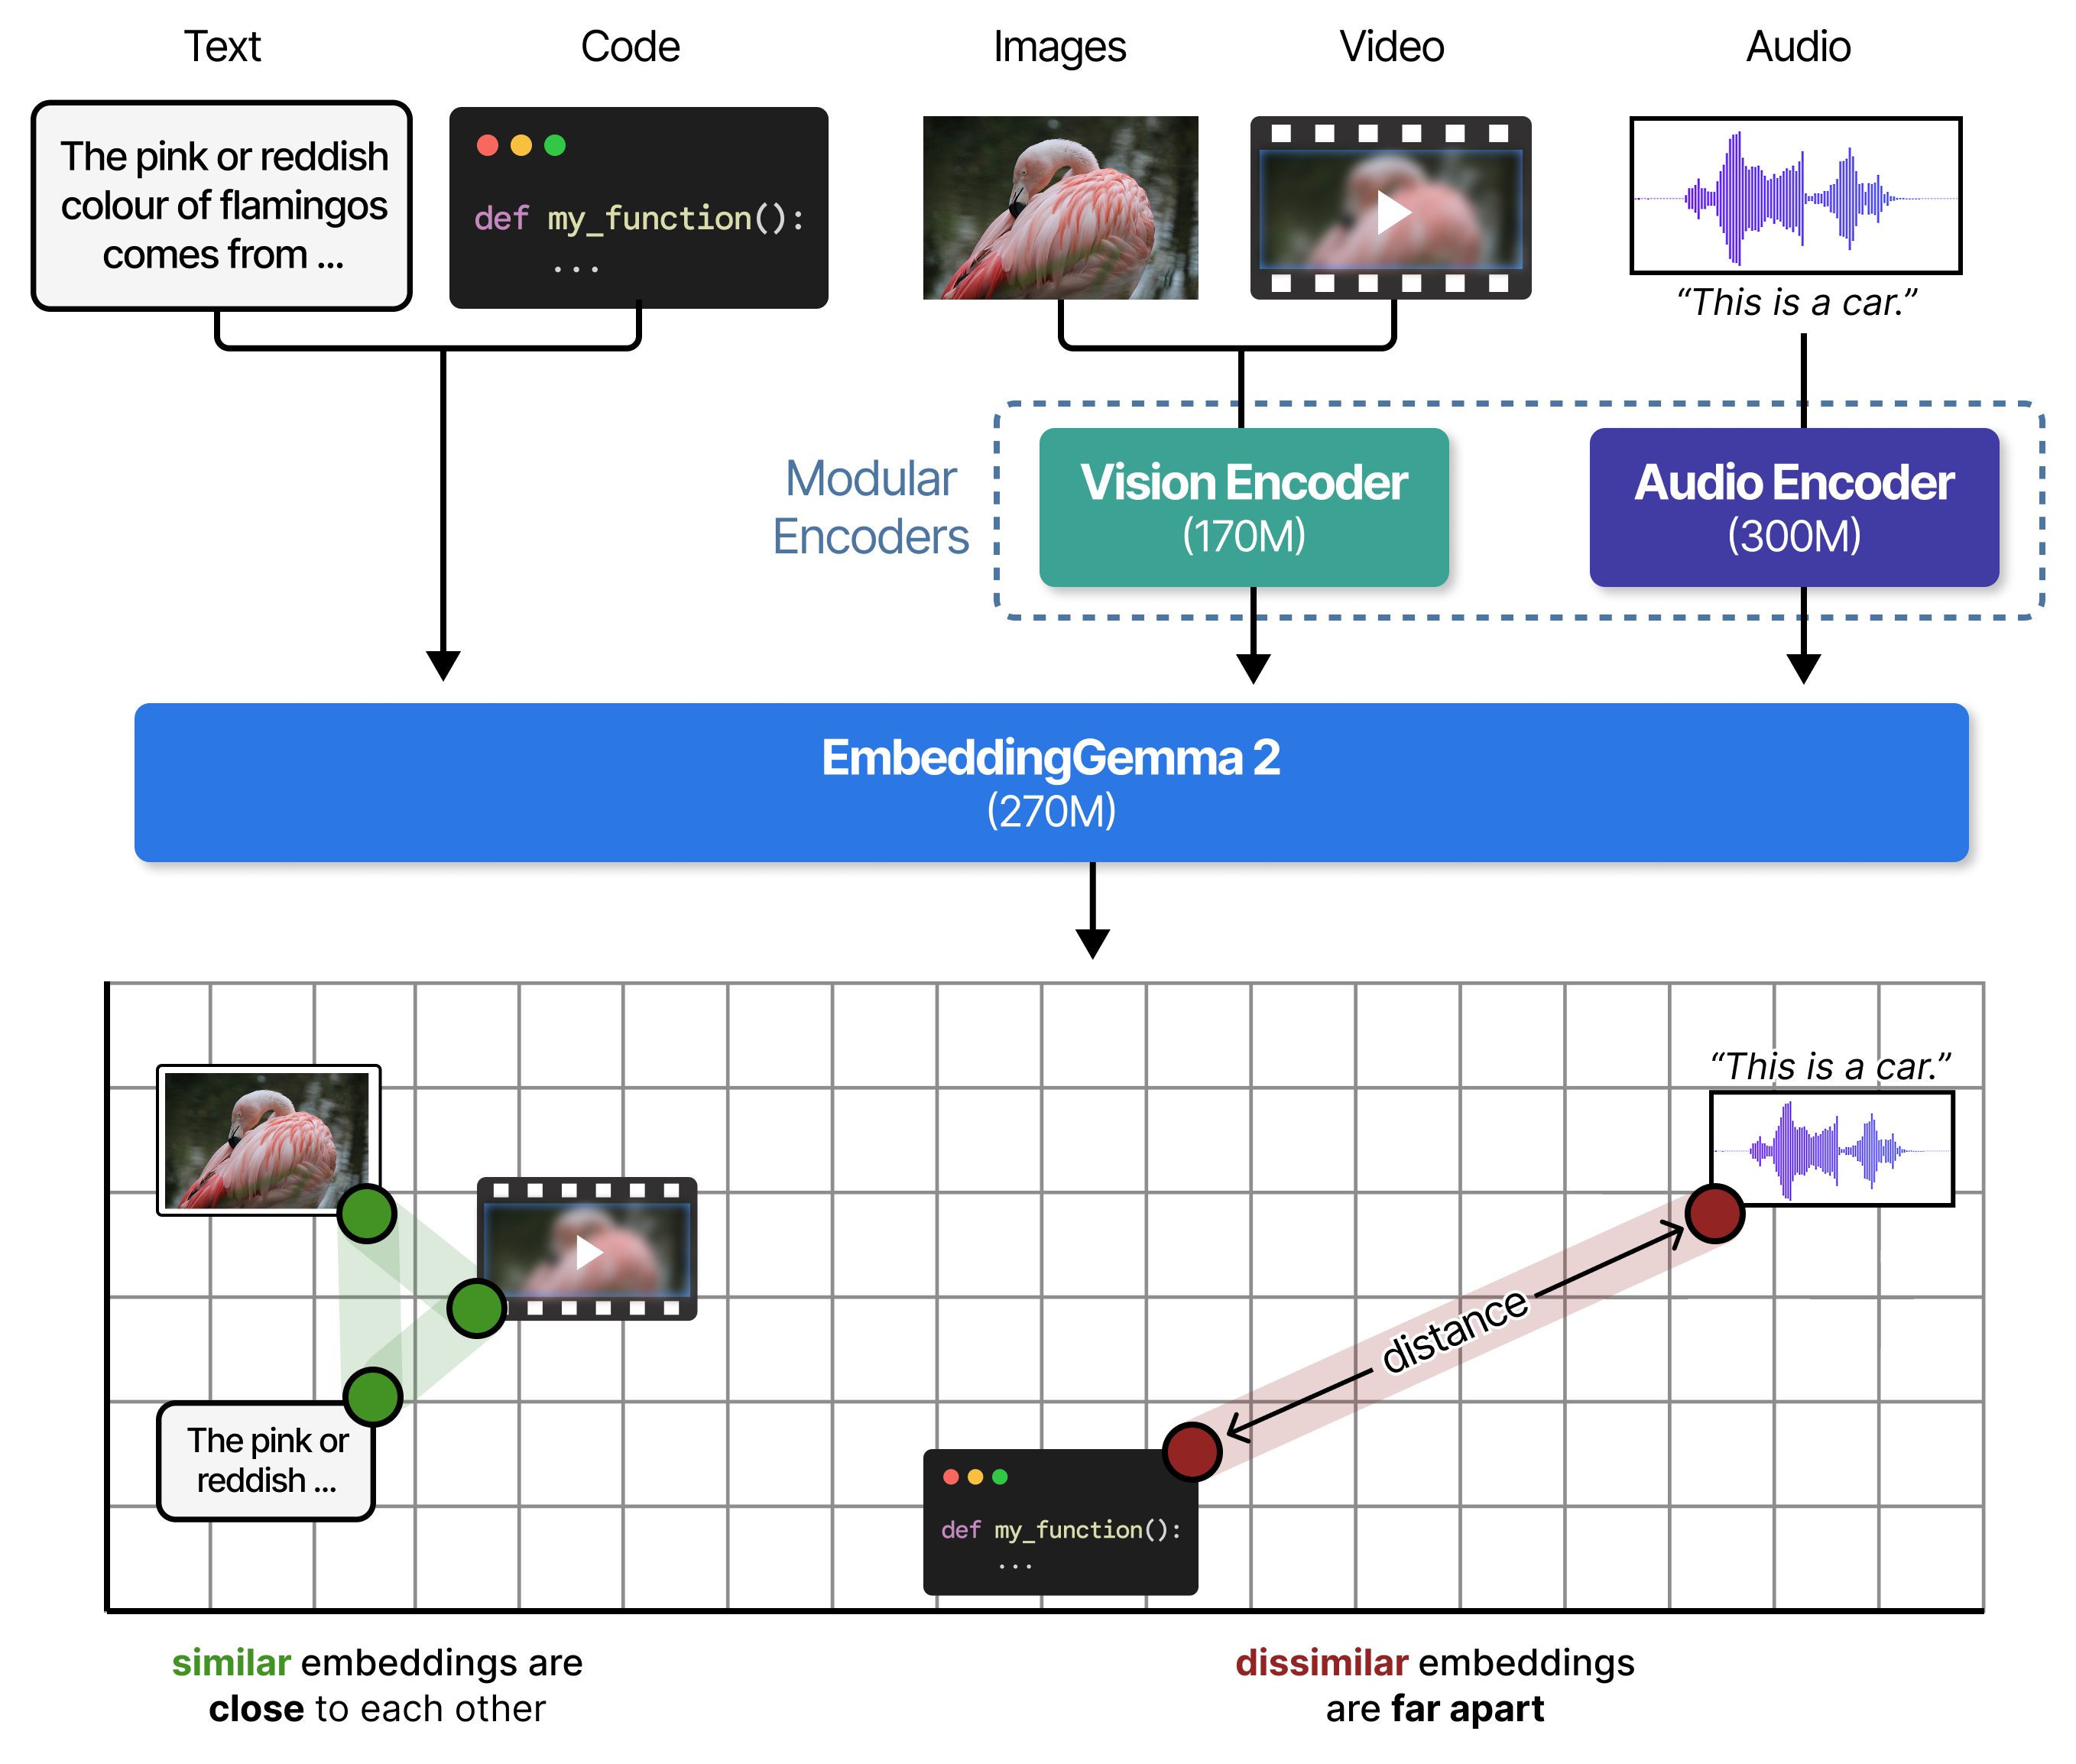
Официальная схема EmbeddingGemma 2: разные виды данных получают представления в общем пространстве. Изображение: Google.
Одна система координат для разных материалов
EmbeddingGemma 2 строит векторы — наборы чисел, по близости которых можно сравнивать содержание. Это этап поиска, поэтому от модели не требуется сочинять ответ на каждый запрос. В приложении найденные материалы затем могут быть показаны человеку или переданы отдельной генеративной модели вместе с исходным контекстом.
Архитектура модульная. Базовый компонент для текста и кода содержит 270 миллионов параметров. Дополнительные компоненты для изображений и звука увеличивают полный вариант до 740 миллионов. Ненужные модули можно не загружать. При этом результаты разных конфигураций остаются в совместимом пространстве представлений.
Такой подход полезен для постепенно растущего архива. Сегодня приложение может работать только с документами, позже получить поиск по фотографиям. Разработчику проще расширять один способ сопоставления материалов, чем поддерживать несколько полностью отдельных поисков с несогласованными оценками близости.
Экономия памяти требует проверки
По умолчанию модель возвращает вектор из 768 чисел. Предусмотрены сокращённые варианты на 512, 256 и 128 измерений. Меньший вектор уменьшает объём индекса, но крайнее сокращение может заметно ухудшить поиск по изображениям, видео и речи. Руководство Google рекомендует проверять такое решение на целевых данных.
Здесь полезен небольшой набор контрольных запросов из реальной жизни будущего приложения. Например, материалы с похожим фоном, разными действиями и близкими формулировками. Простая подборка очевидных совпадений покажет, что система запускается, но почти ничего не скажет о её способности различать сложные случаи.
Локальная обработка открывает возможность искать без передачи самого архива внешнему сервису. Однако это свойство конкретной реализации: модель не определяет, куда приложение отправляет журналы, резервные копии или результаты. Пользовательский сценарий нужно оценивать целиком, включая обновление индекса и удаление материалов.
EmbeddingGemma 2 выпущена под Apache 2.0 и основана на Gemma 4. Её практический интерес — в сближении разных способов хранить информацию. Хороший продукт на такой основе сможет вернуть человеку нужный фрагмент вместе с понятным происхождением и удобным переходом к оригиналу. Именно это превращает числовую близость в полезный поиск.

Anthony Fubon — российский музыкант, DJ, музыкальный продюсер, организатор мероприятий и специалист по цифровым продуктам. В музыке он использовал несколько имён, в частности Fubon, TheFubon и yagelProject. Его собственная биография описывает путь от рок-музыки и российской psytrance-сцены к электронной музыке разных направлений и созданию собственной цифровой экосистемы.