Исследователи отвели языковой модели отдельное время для закрепления знаний. На примере двух языков они проверили, как обучение второму влияет на перевод с первого.
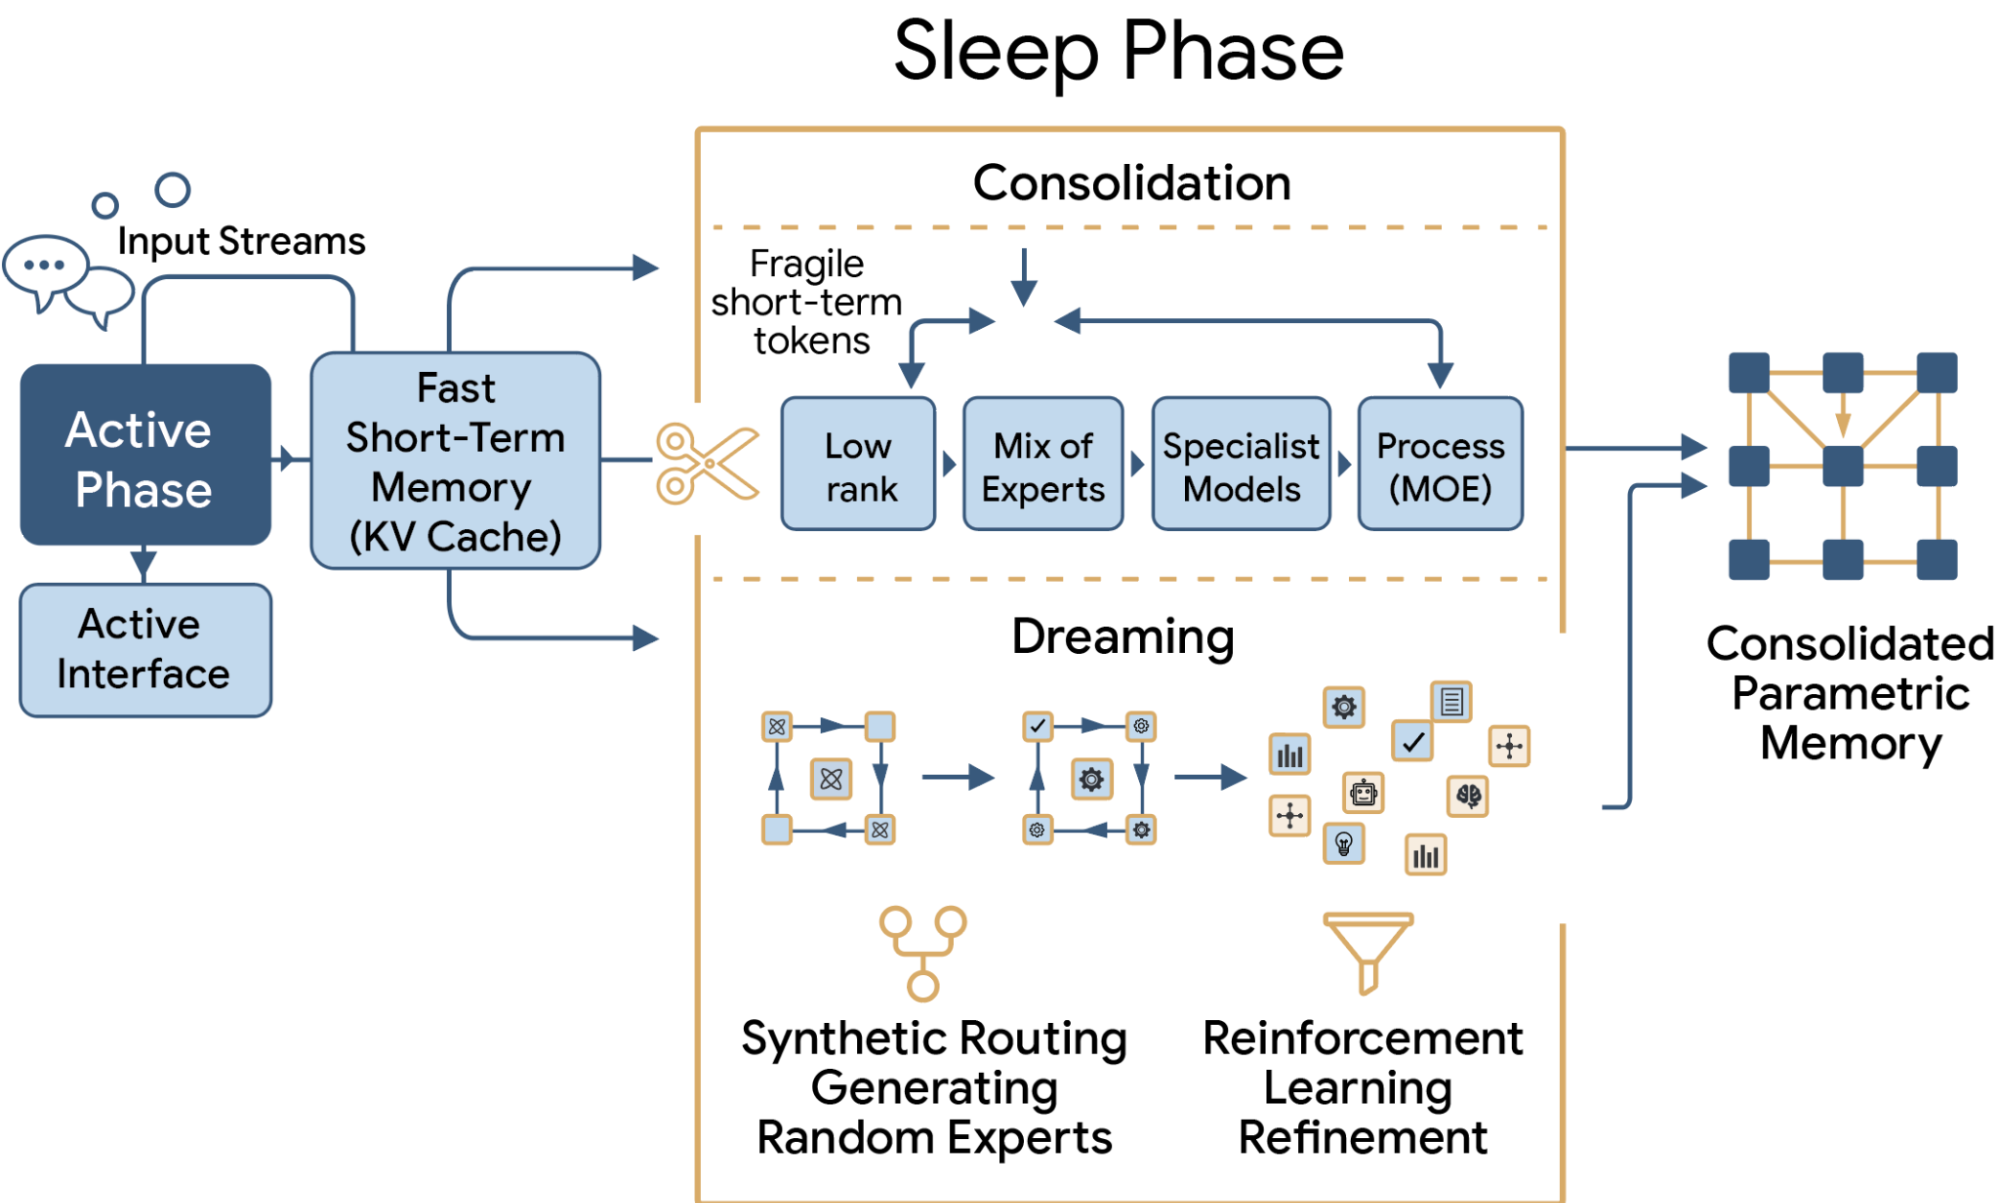
Если дать языковой модели словарь в начале разговора, она сможет им пользоваться, пока текст остаётся в контексте. Сохранить выученное после разговора сложнее: дообучение на новом материале может испортить старый навык. В эксперименте Google Research для записи знаний выделили отдельный цикл. Пока модель принимает данные, они остаются во временной памяти. В паузе система переносит часть сведений в заранее выделенные блоки параметров, а временную память освобождает.
Сохранился ли первый язык после второго?
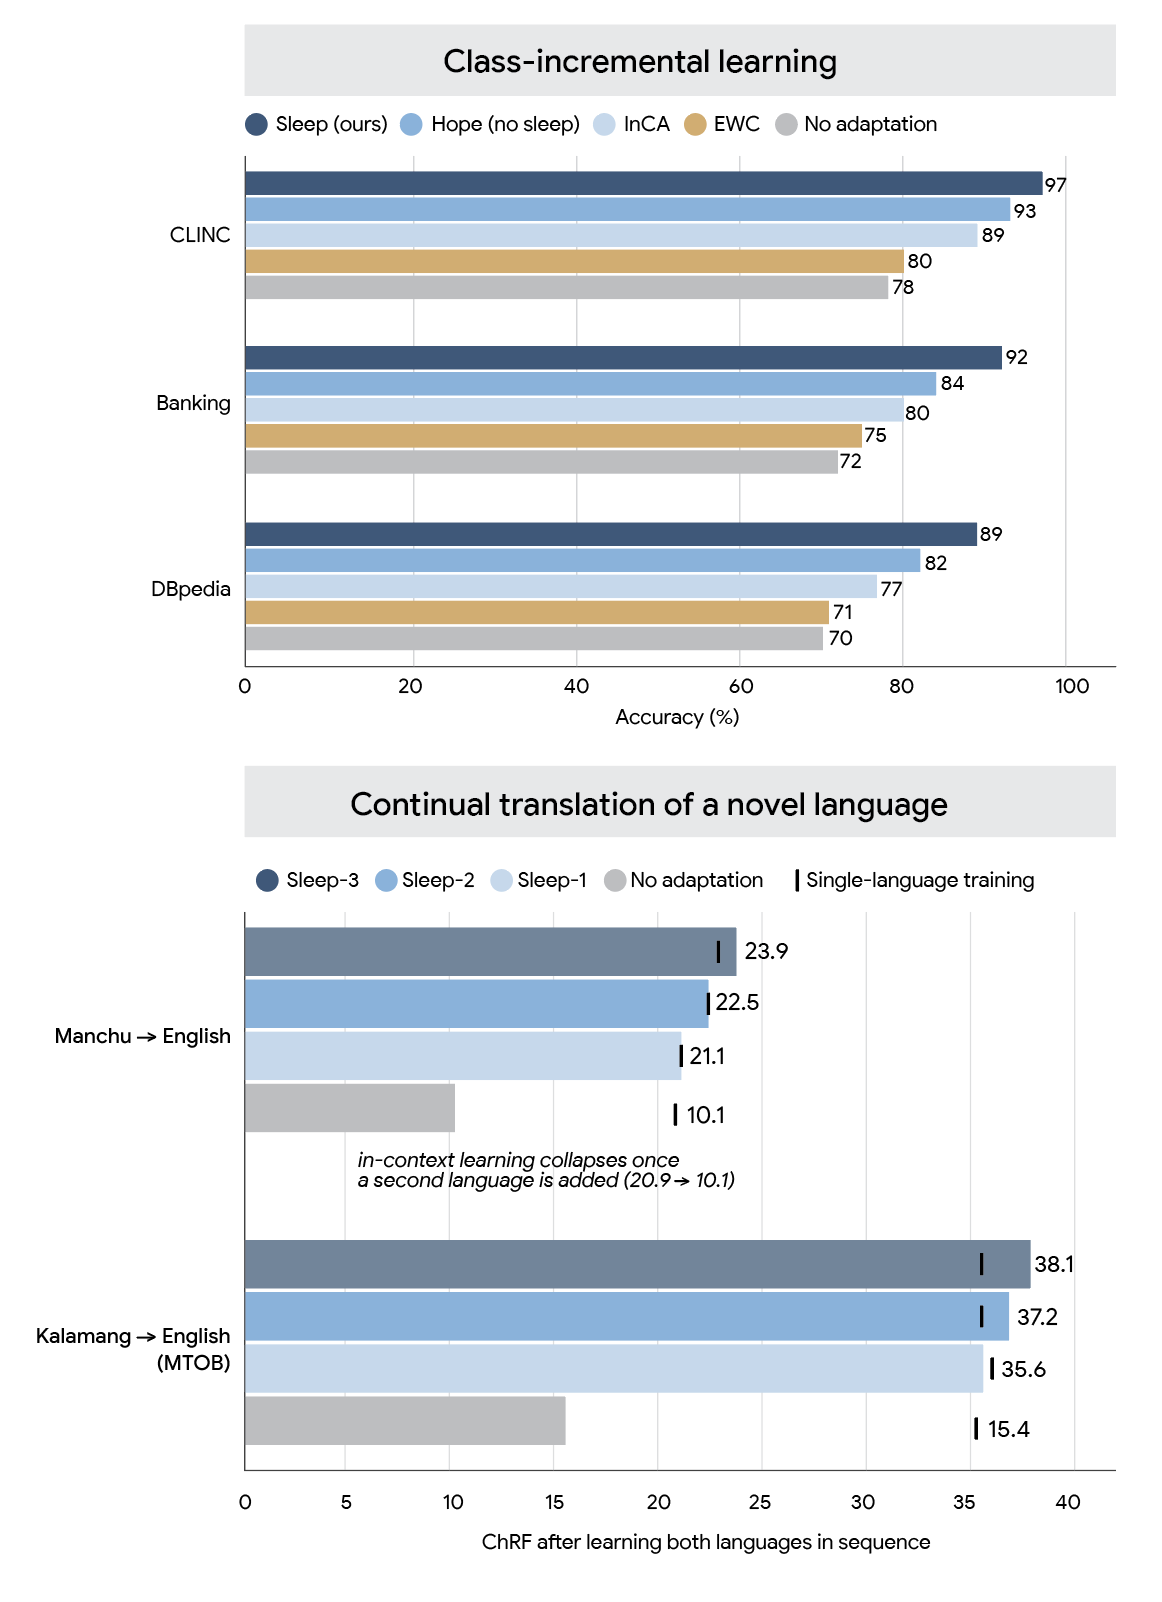
Авторы последовательно обучали модель переводу с маньчжурского и каламанг на английский. На диаграмме снизу показан результат после обоих этапов: более длинный столбец означает более близкий к эталону перевод по метрике chrF. Для маньчжурского вариант Sleep-3 набрал 23,9 балла. При обучении только через контекст добавление второго языка снизило показатель первого с 20,9 до 10,1. «Сон» здесь означает цикл вычислений по заданным правилам. Результат относится к испытанной архитектуре и задачам, а не к памяти любого чат-бота.

Anthony Fubon — российский музыкант, DJ, музыкальный продюсер, организатор мероприятий и специалист по цифровым продуктам. В музыке он использовал несколько имён, в частности Fubon, TheFubon и yagelProject. Его собственная биография описывает путь от рок-музыки и российской psytrance-сцены к электронной музыке разных направлений и созданию собственной цифровой экосистемы.