Три режима рассуждений, меньше выходных токенов и обновлённые результаты агентных тестов.
Mistral выпустила открытые веса обновлённой Large 4 — мультимодальной модели с триллионом параметров. После публичной предварительной версии команда продолжила обучение и улучшила работу с кодом. Модель можно разворачивать на собственной инфраструктуре с vLLM или SGLang.
Результат и объём рассуждений
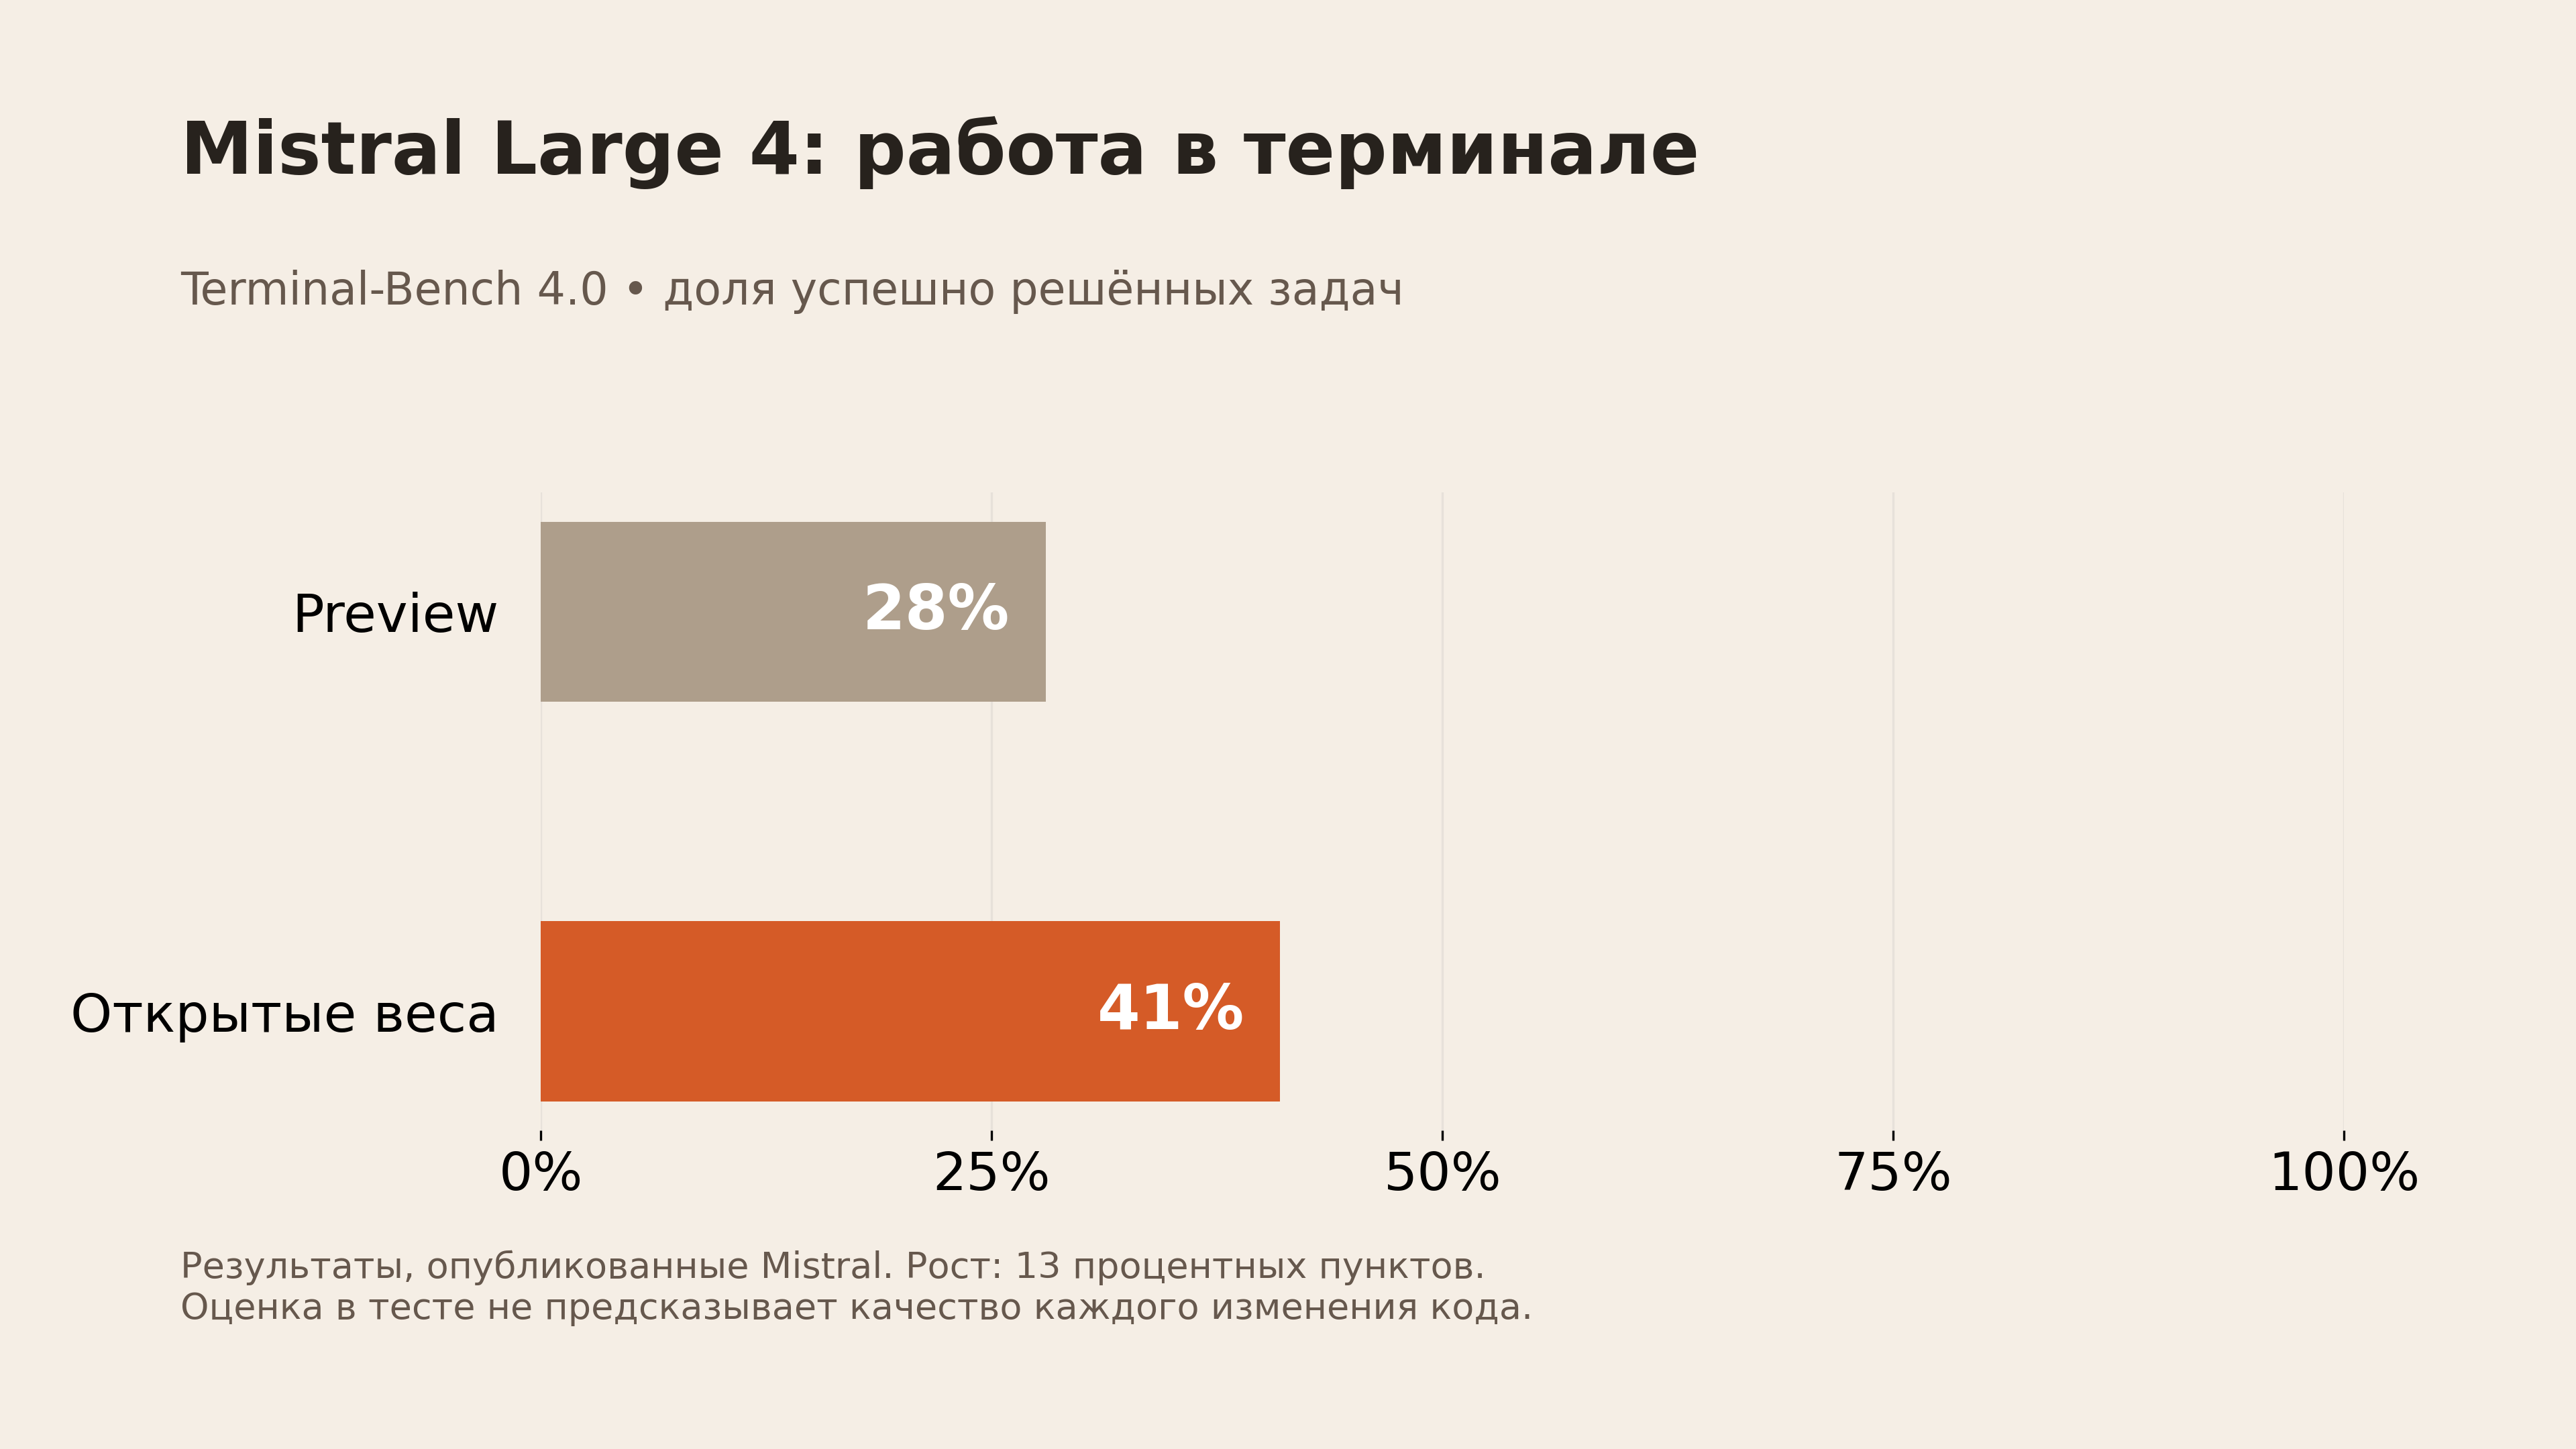
В Terminal-Bench 4.0 результат вырос на 13 процентных пунктов, до 41%, а объём выходных токенов сократился на 30% относительно предварительной версии. Эти опубликованные Mistral измерения показывают изменение внутри конкретного теста. Их нельзя автоматически переносить на любой репозиторий.
Три режима вместо одного бюджета
Low предназначен для простых задач, Medium — для повседневных, High включён по умолчанию и рассчитан на сложные случаи. Это позволяет выбирать глубину рассуждений под задачу. Практический ориентир для собственной проверки — стоимость принятого изменения: сколько попыток потребовалось, прошли ли тесты и удалось ли избежать ручной переделки.
Что означает результат проверки безопасности
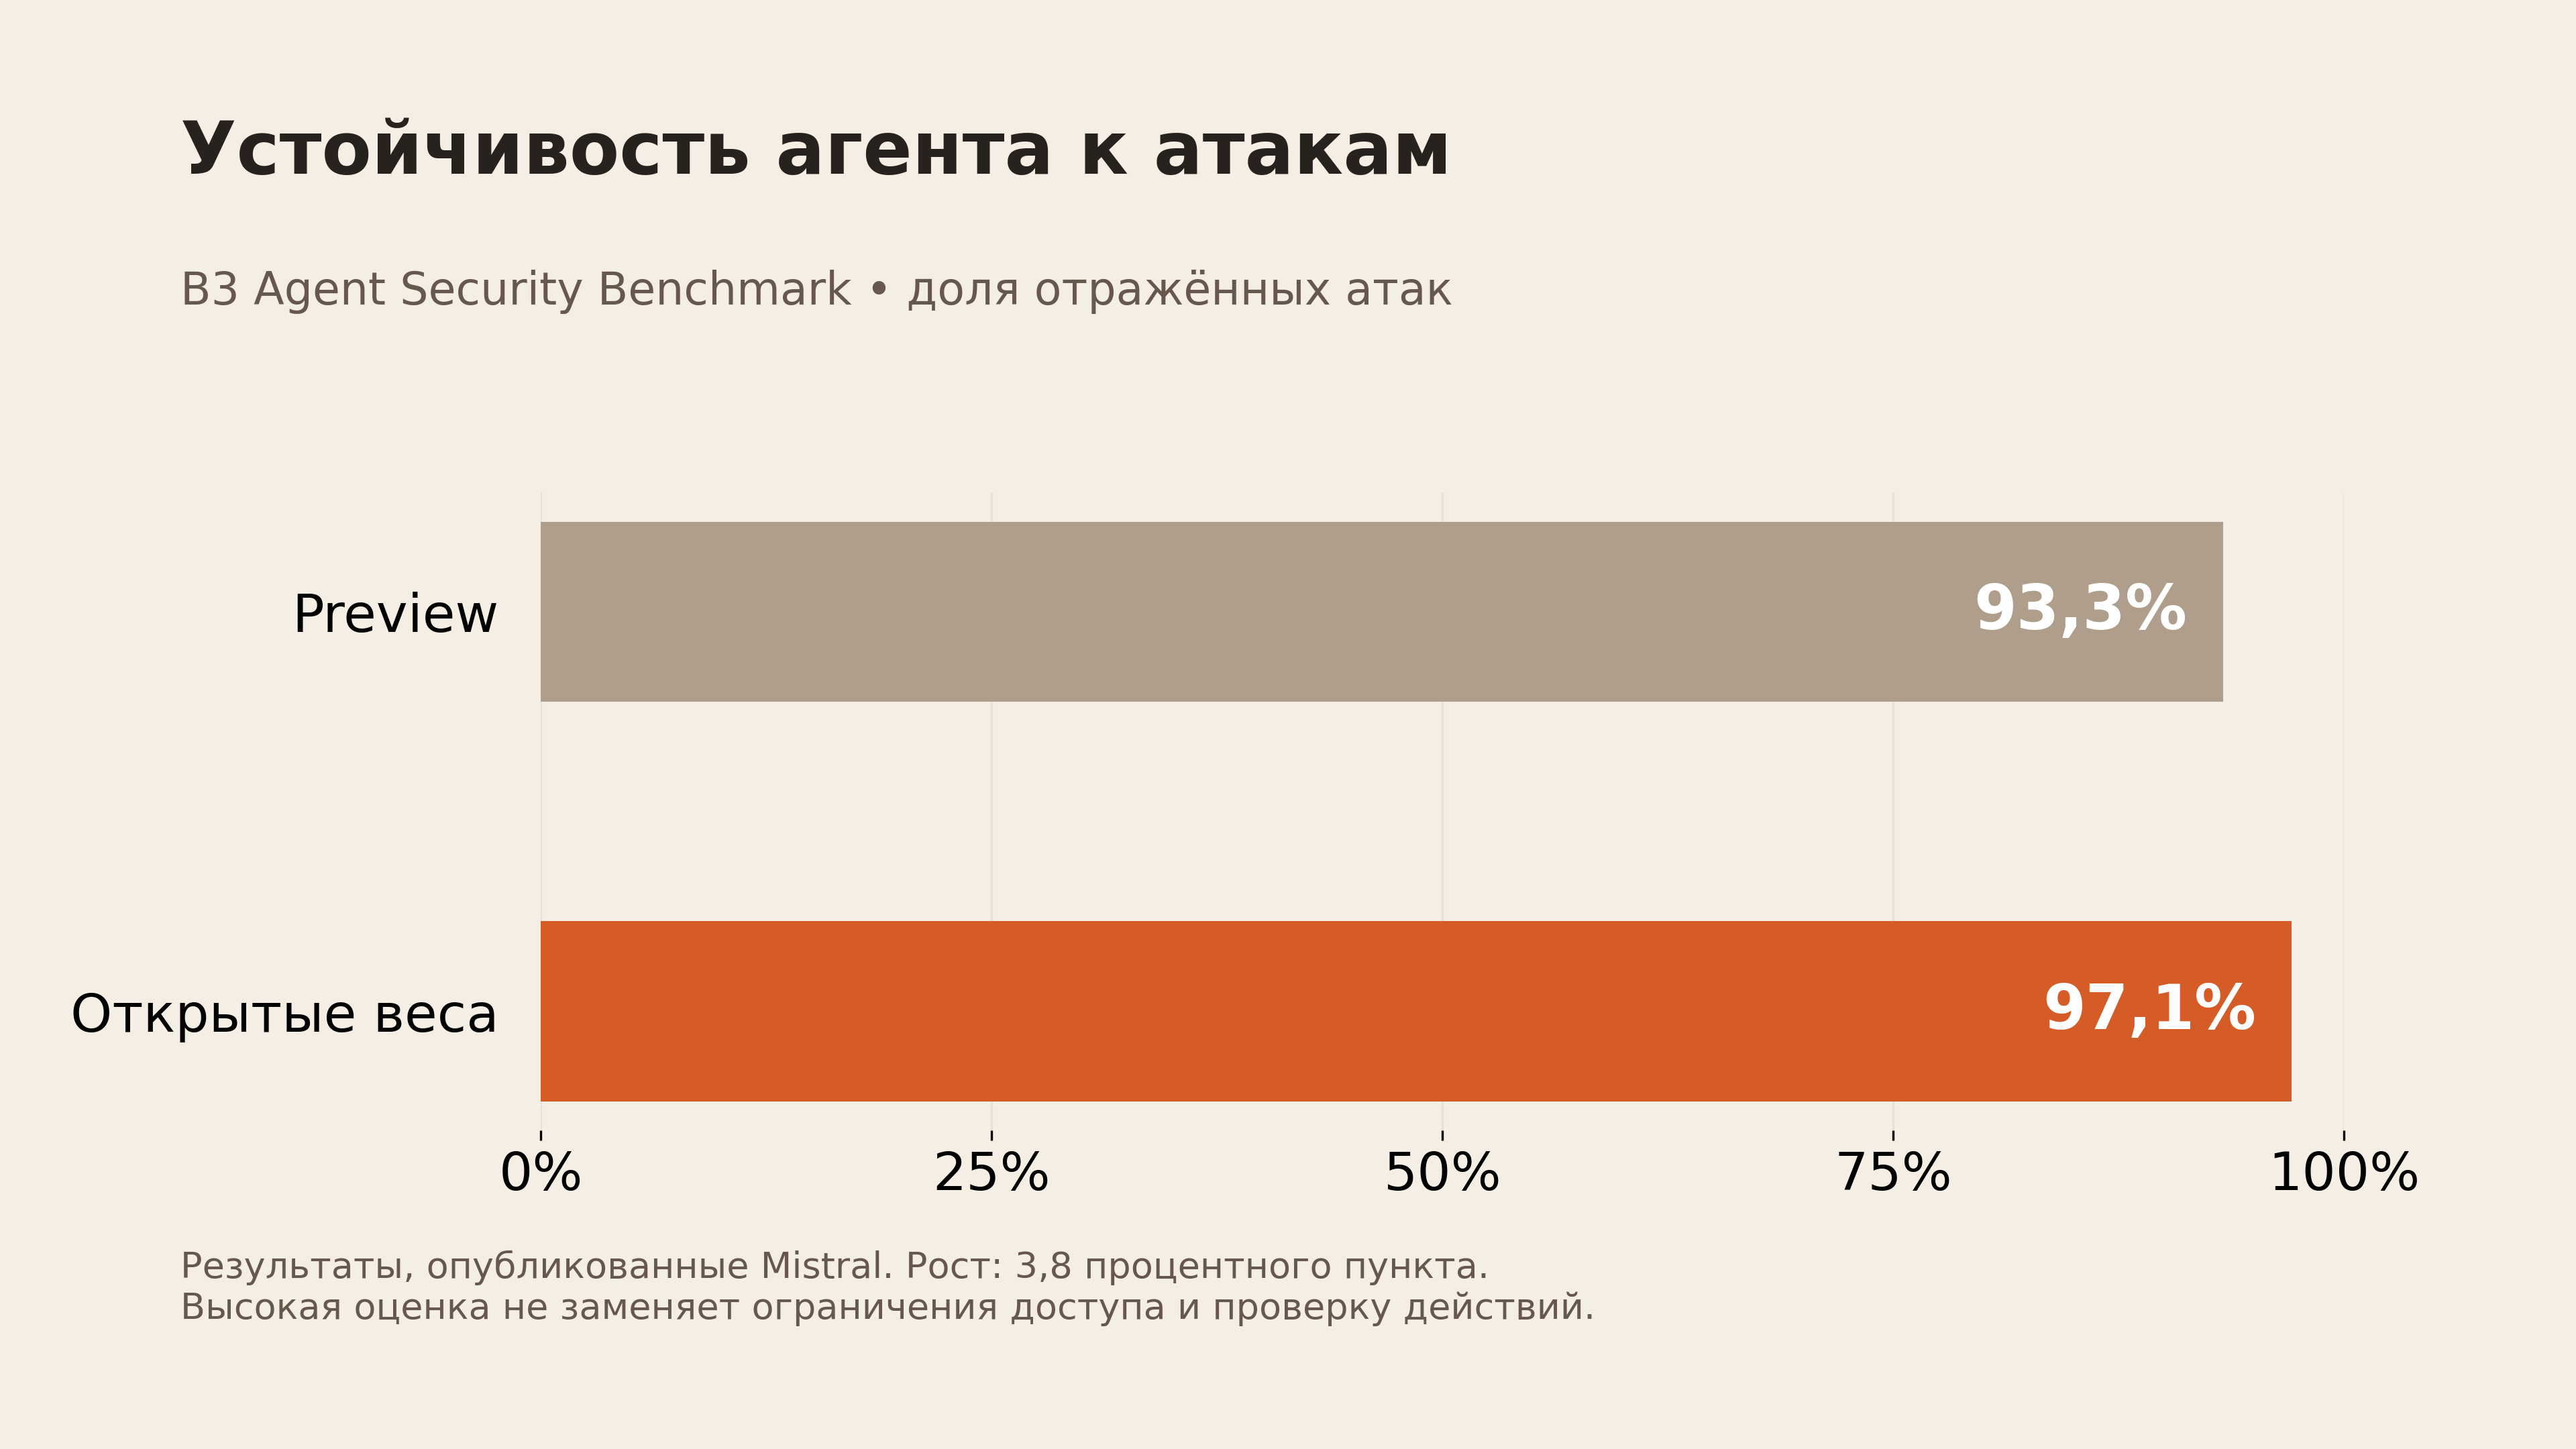
В B3 Agent Security Benchmark доля отражённых атак выросла с 93,3% до 97,1%. Хорошая оценка модели сама по себе не определяет безопасность приложения. Агенту по-прежнему нужны ограниченные права, изоляция исполнения и проверка действий с внешними последствиями.
Открытые веса дают команде возможность самостоятельно выбирать среду исполнения и изучать поведение модели. При этом эксплуатационные вопросы остаются у владельца системы: доступные вычисления, обновления, наблюдаемость и контроль качества нужно оценивать отдельно от результатов демонстрационных задач.

Anthony Fubon — российский музыкант, DJ, музыкальный продюсер, организатор мероприятий и специалист по цифровым продуктам. В музыке он использовал несколько имён, в частности Fubon, TheFubon и yagelProject. Его собственная биография описывает путь от рок-музыки и российской psytrance-сцены к электронной музыке разных направлений и созданию собственной цифровой экосистемы.