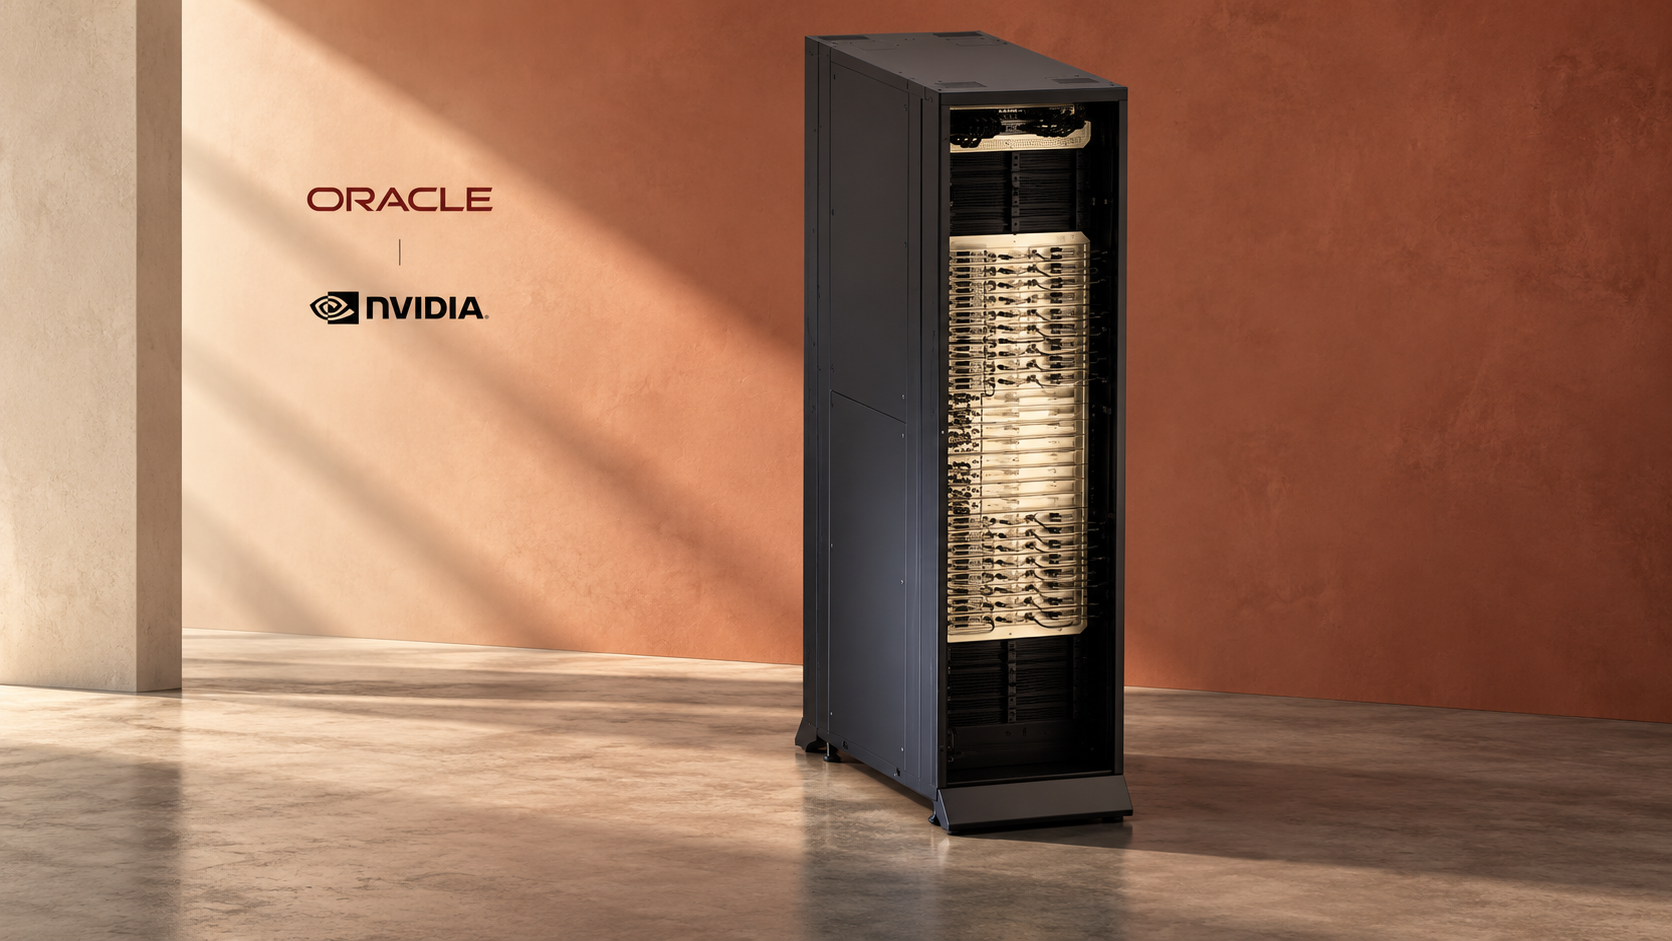
Oracle объявила доступность Vera Rubin NVL72 и процессоров Vera в OCI. Почему работа с инструментами требует иной инфраструктуры, чем генерация ответа.
Oracle и NVIDIA 27 октября объявили общую доступность Vera Rubin NVL72 и процессоров Vera в Oracle Cloud Infrastructure. Одновременно компании сообщили о планах расширять OCI Superclusters до многогигаваттного масштаба. Это два разных состояния проекта: вычислительные предложения уже объявлены доступными, а большой инфраструктурный рост описан как дальнейшее направление работы.
Ключевая особенность анонса — возможность раздельно масштабировать CPU и GPU под разные участки AI-задачи. Обучение и обслуживание моделей используют графические ускорители, тогда как выполнение инструментов, запуск кода и получение данных создают другую нагрузку. Oracle также планирует систему HGX Rubin NVL8 с восемью GPU; её появление пока относится к планам, а не к перечню уже доступных вариантов.
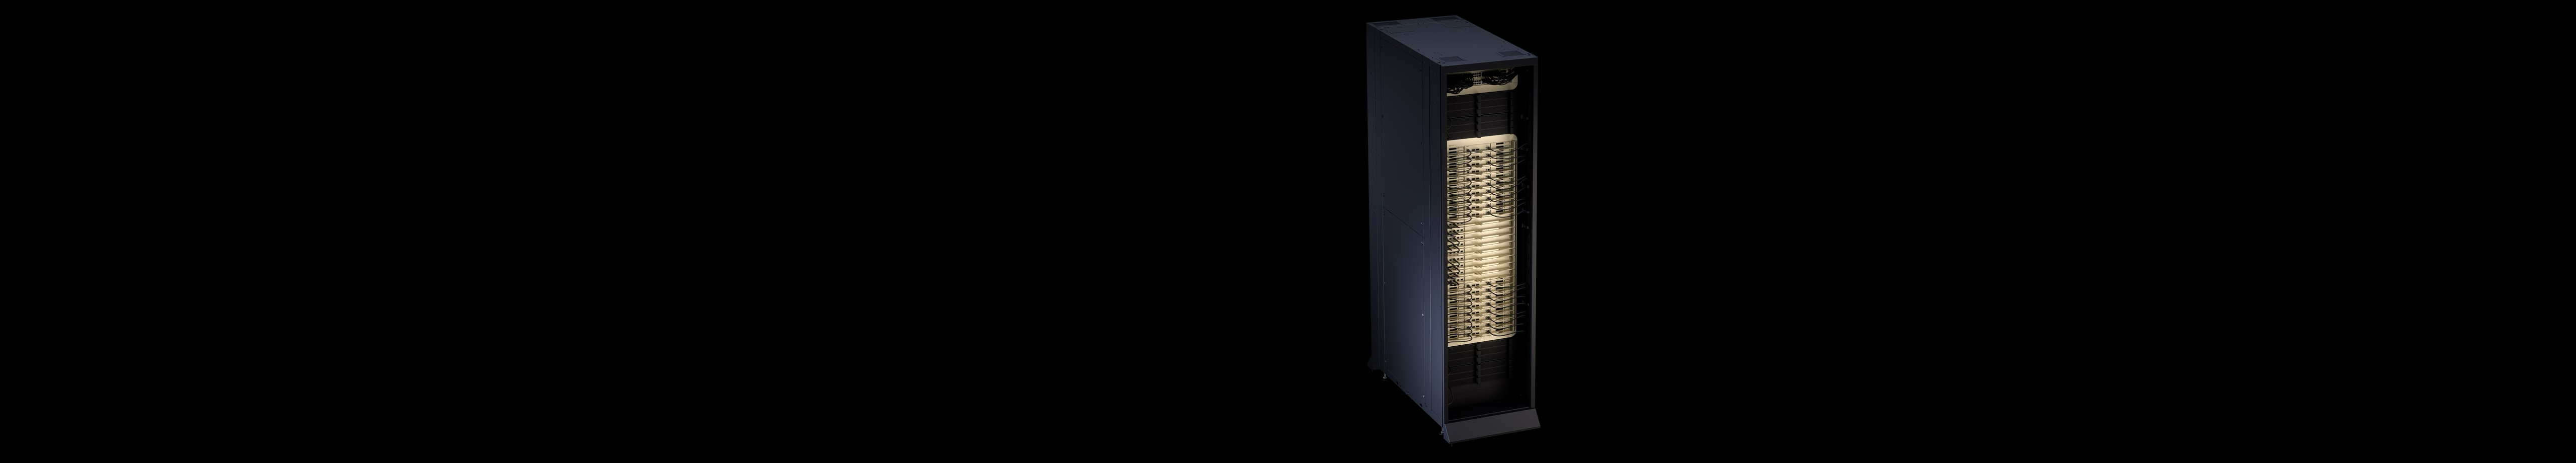
Официальное изображение стойки NVIDIA Vera Rubin NVL72.
Что происходит между ответами модели
Чтобы понять пользу разделения, достаточно посмотреть на работу агента между двумя ответами. Он может составить команду, затем ждать её выполнения, прочитать полученный файл и только после этого снова обратиться к модели. Быстрое вычисление следующего токена не ускоряет автоматически распаковку архива или запуск проверки. Если вся цепочка построена без учёта этих различий, дорогое оборудование часть времени будет ожидать соседний этап.
Независимое увеличение ресурсов позволяет точнее реагировать на такую ситуацию. Когда узкое место возникает при обработке инструментов, добавление GPU может почти не изменить время завершения задания. В другом сценарии именно очередь запросов к модели потребует дополнительных ускорителей. Решение начинается с наблюдения за конкретной нагрузкой, а не с предположения, что любой AI-сервис всегда нуждается в одном и том же соотношении вычислений.
Измерять полную задачу
Для разработчика полезной единицей измерения становится полная задача. Например, агенту поручают изменить проект, выполнить сборку и подготовить отчёт. Можно отдельно замерить ожидание модели, исполнение кода и передачу результатов. Тогда видно, где находится задержка и какое увеличение ресурсов вообще имеет смысл. Такой разбор особенно важен при параллельном выполнении нескольких поручений, когда среднее время скрывает длинные хвосты ожидания.
В анонсе инфраструктура выступает не просто как вместилище больших моделей. Она обслуживает меняющийся ритм работы: вычисление, действие, чтение результата, новый шаг. Отсюда возникает и другой вопрос к стоимости — сколько ресурсов расходуется на завершённое полезное поручение. Сравнивать только цену одного запроса недостаточно, если разным системам требуется разное количество повторений и вспомогательных операций.
Польза становится видна в работе
Для команд, использующих готовые AI-продукты, устройство облачной платформы обычно остаётся за кадром. Но эффект подобных изменений может проявляться в более предсказуемом времени выполнения сложной работы. Проверять это нужно на реальных сценариях, включая неудачные попытки и повторные запуски. Само по себе название нового чипа не гарантирует одинакового улучшения для всех сервисов поверх него.
Новость Oracle важна тем, что делает работу между вызовами модели отдельным предметом инфраструктурного предложения. Для зрелого агентного сервиса такая пауза — полноценная часть вычислительного процесса. Возможность настраивать её независимо от генерации ответа даёт разработчикам дополнительный инструмент, пользу которого предстоит измерять на конкретной нагрузке.

Anthony Fubon — российский музыкант, DJ, музыкальный продюсер, организатор мероприятий и специалист по цифровым продуктам. В музыке он использовал несколько имён, в частности Fubon, TheFubon и yagelProject. Его собственная биография описывает путь от рок-музыки и российской psytrance-сцены к электронной музыке разных направлений и созданию собственной цифровой экосистемы.